Modèles et IA · 8 min de lecture · Mis à jour le 2026-09-02
Quelles différences entre les modèles et pour quelles tâches les utiliser ?
Choisissez selon la fenêtre de contexte, la profondeur de raisonnement et les outils : développement complexe, documents longs, analyse d’images et questions courantes nécessitent des capacités différentes.
Le plus grand modèle n’est pas toujours le meilleur choix. Vérifiez d’abord les besoins en contexte long, raisonnement approfondi, compréhension d’images ou appels d’outils. La liste et les capacités évoluent selon les versions ; cet article repose sur les vérifications du client actuel.
À retenir d’abord
- Pour une question courte ou quelques phrases à réécrire, privilégiez un modèle léger et rapide.
- Pour lire de longs documents, développer des fonctions complexes ou réaliser plusieurs étapes, privilégiez un contexte long et un raisonnement plus approfondi.
- Pour rechercher, ouvrir des documents ou utiliser des tableaux ou un navigateur, vérifiez d’abord la prise en charge des appels d’outils.
- La mention « Conversation uniquement » signifie que le modèle peut discuter, résumer et réécrire, mais que le client actuel n’utilisera pas les outils de recherche, de tableaux, etc.
Choisir d’abord selon la tâche
| Votre objectif | À essayer en premier | Critères de choix |
|---|---|---|
| Questions courantes, réécriture, résumés | DeepSeek-V4-flash、Doubao Seed 2.0 Lite | Vitesse de réponse et besoin d’outils |
| Développement complexe, migration de code, processus longs | GLM-5.2、DeepSeek-V4-pro、Kimi K3 | Fenêtre de contexte, profondeur de raisonnement, appels d’outils |
| Tâches de programmation | Kimi K2.7 Code、GLM-5.2、DeepSeek-V4-pro、Doubao Seed Evolving | Prise en charge des outils et longueur du contexte |
| Images ou autres contenus multimodaux | Kimi K3、Kimi K2.7 Code、Doubao Seed 2.0 Lite | Capacités multimodales et besoin d’outils |
| Discussion, résumé et réécriture uniquement | MiniMax-M3、MiniMax M3 (1M) | Mention « Conversation uniquement » ; aucun appel d’outil |
| Forte concurrence de requêtes et budget limité | DeepSeek-V4-flash | Vitesse et indications de coût des modèles légers ; la facturation dépend du forfait ou du fournisseur |
Ce tableau est un point de départ fondé sur les capacités affichées dans le client actuel, pas un classement fixe. Les noms, capacités et prix peuvent évoluer. Avant de choisir, consultez les informations actuelles du sélecteur.
Vérifier les trois capacités de la fiche du modèle
Fenêtre de contexte
La fenêtre de contexte détermine la quantité de contenu qu’une conversation peut contenir. 1M convient aux bases de code, documents et comptes rendus volumineux ; 262K ou 256K aux tâches de taille moyenne ; 200K suffit aux questions courantes, selon leur longueur. Un contexte plus grand ne garantit pas une meilleure réponse ; plus le contenu est abondant, plus les instructions doivent être claires.
Profondeur de raisonnement
Le sélecteur propose notamment « Désactivé », « Standard » et « Approfondi ». Commencez par « Désactivé » ou « Standard » pour les questions courantes, puis augmentez pour les raisonnements complexes, migrations de code ou processus longs. Un raisonnement plus approfondi entraîne généralement plus d’attente et peut consommer davantage de quota du fournisseur.
Appels d’outils
Pour rechercher, ouvrir des documents, manipuler des tableaux ou utiliser le navigateur, choisissez impérativement un modèle compatible avec les appels d’outils. Les modèles « Conversation uniquement » sont signalés et leurs capacités à droite ne comprennent pas d’outils. Ce n’est pas une panne, mais une limite du service.
Répartition des modèles actuels par usage
Modèles de la plateforme : prêts à l’emploi
TabTin fournit ces modèles sans que vous ayez à saisir une adresse API ou une clé. Le client actuel les répartit entre les groupes « Volcano Engine » et « Moonshot » :
- GLM-5.2 : adapté au développement complexe, à la compréhension de contextes longs et aux tâches prolongées ; la fiche indique un contexte 1M et une intensité de raisonnement plus flexible.
- DeepSeek-V4-pro : adapté aux Agents de production, au code complexe et aux tâches à contexte long ; la fiche indique 1,6T de paramètres au total, 49B activés et un contexte 1M.
- DeepSeek-V4-flash : adapté aux tâches courantes avec de nombreuses requêtes simultanées et un budget limité ; la fiche le présente comme une version légère avec un contexte 1M.
- Doubao Seed Evolving : adapté à la programmation, aux Agents et à la productivité ; il utilise un identifiant de modèle unifié et ses capacités évoluent continuellement.
- Doubao Seed 2.0 Lite : adapté aux questions courantes, aux analyses légères et aux tâches moyennes nécessitant images ou outils ; la fiche indique un contexte 256K et des capacités multimodales et d’outils.
- Kimi K3 : adapté aux documents longs, au raisonnement complexe et aux tâches multimodales ; la fiche indique un contexte 1M, un raisonnement toujours actif et un contrôle de sa profondeur.
- Kimi K2.7 Code : adapté à la programmation ; la fiche indique un contexte 262K, la multimodalité, les outils et le raisonnement.
- Kimi K2.6 / K2.5 : adapté aux questions générales, à l’analyse et au code avec un contexte moyen à long ; la fiche indique un contexte 262K, la multimodalité, les outils et le raisonnement.
BYOK de l’organisation : utiliser les services connectés par l’organisation
Le groupe « BYOK de l’organisation » contient les services connectés par son administrateur. Dans l’exemple du client actuel, les modèles MiniMax portent la mention « Conversation uniquement » :
- MiniMax-M3 : fenêtre de contexte 200K, adaptée à la discussion, au résumé, à la réécriture et aux tâches sans outils.
- MiniMax M3 (1M) : malgré le nom contenant 1M, le client actuel le marque « Conversation uniquement ». Pour le contexte réel, consultez le panneau de droite après sélection ; ce nom ne signifie pas que les outils de recherche, de tableaux ou de navigateur sont disponibles.
Les modèles BYOK, leur contexte et leur facturation dépendent de la configuration de l’organisation et du fournisseur. Si un modèle est absent, contactez d’abord l’administrateur pour vérifier que le service est connecté et dispose encore de quota.
Consulter et changer le modèle dans une tâche
1. Ouvrir le sélecteur de modèles
Après avoir créé une tâche, cliquez sur le nom du modèle sous le champ de saisie. Les modèles sont regroupés par plateforme et BYOK de l’organisation. Après sélection, leurs capacités apparaissent à droite.
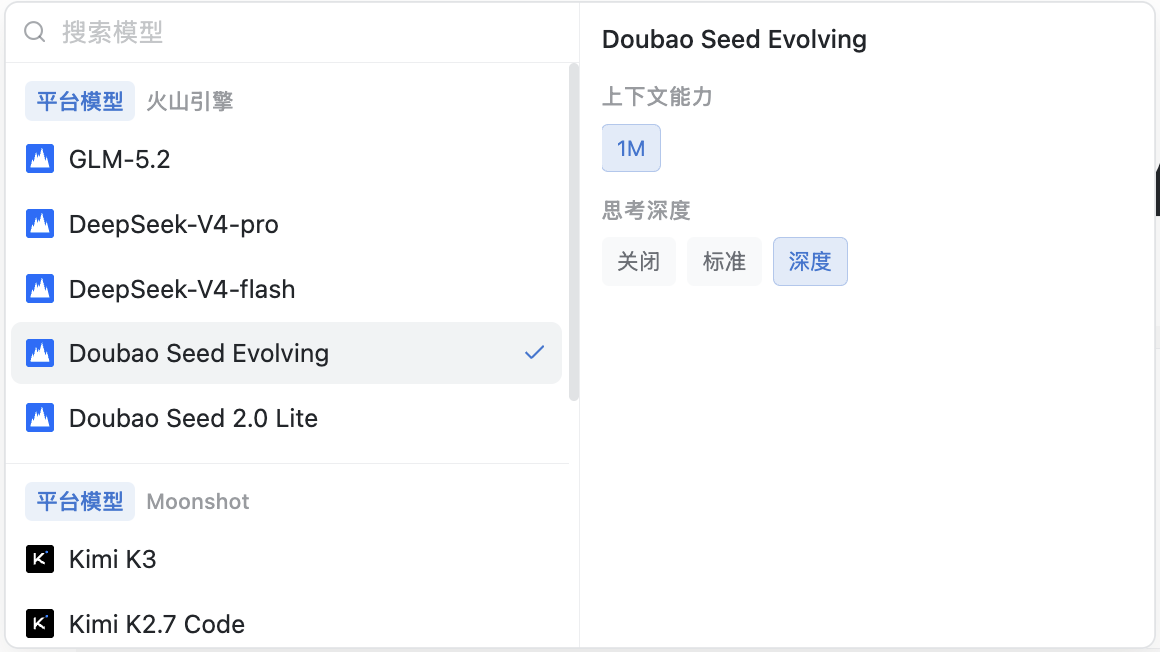
Figure 1 · Le sélecteur affiche les groupes des plateformes, le BYOK de l’organisation, la « Fenêtre de contexte » et la « Profondeur de raisonnement ».
2. Consulter le contexte long et la profondeur de raisonnement
Sélectionnez Kimi K3, GLM-5.2 ou un autre modèle et consultez les capacités de contexte et la profondeur de raisonnement à droite. Pour des documents longs, regardez d’abord la fenêtre de contexte ; pour un raisonnement complexe, choisissez ensuite une profondeur supérieure.
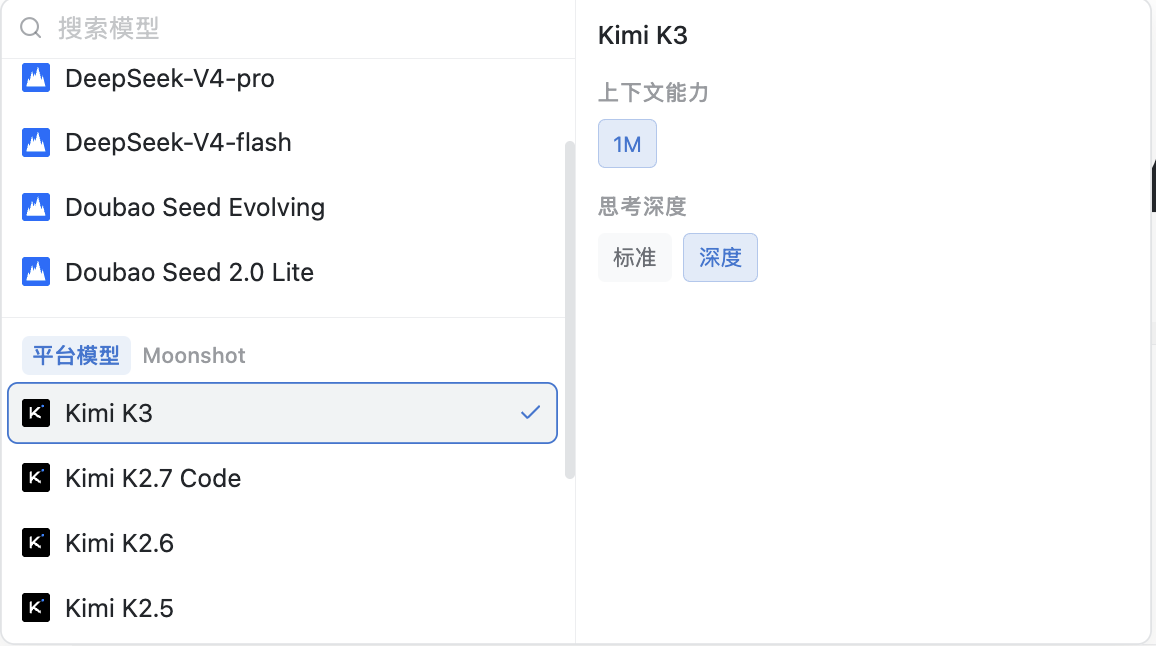
Figure 2 · Kimi K3 affiche actuellement un contexte 1M et deux niveaux de raisonnement : « Standard » et « Approfondi ».
3. Reconnaître les modèles de conversation uniquement
Les modèles BYOK de l’organisation peuvent porter la mention « Conversation uniquement ». Dans le client actuel, c’est le cas de MiniMax-M3 et MiniMax M3 (1M). Ils conviennent aux tâches textuelles, mais pas aux tâches nécessitant recherche, tableaux ou navigateur.
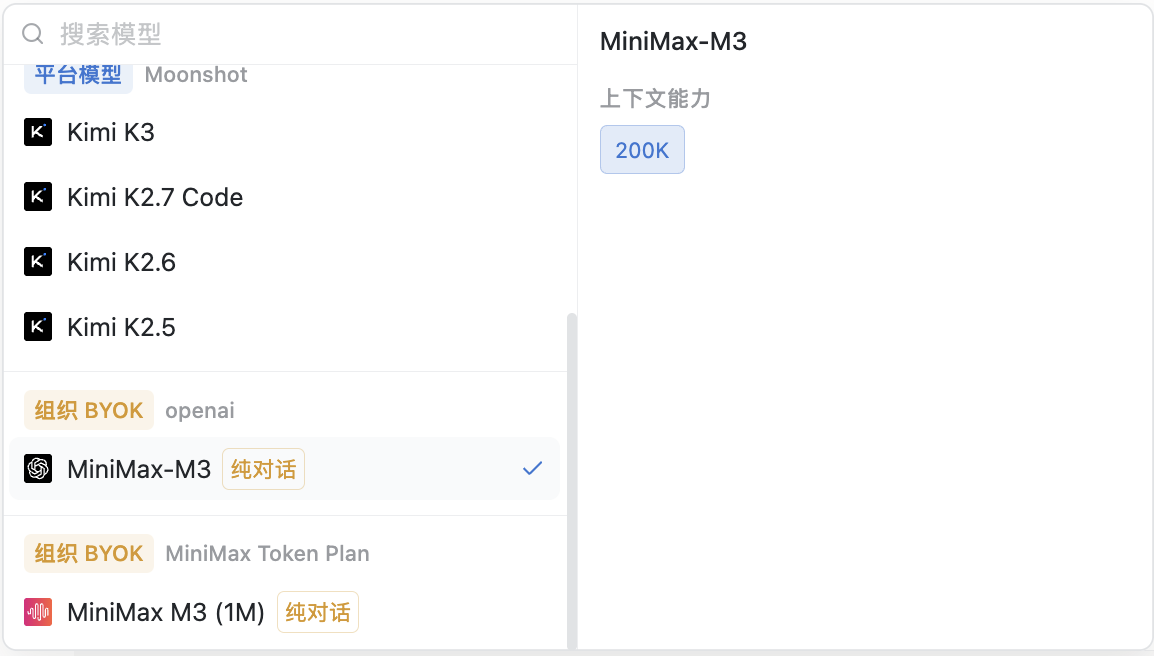
Figure 3 · Le modèle MiniMax porte la mention « Conversation uniquement » ; sa fenêtre de contexte reste affichée à droite.
Dépannage courant
Le modèle discute, mais ne peut pas rechercher ni manipuler des tableaux
Vérifiez la mention « Conversation uniquement » près du nom, puis passez à un modèle de la plateforme compatible avec les outils. Les messages déjà envoyés sont conservés, mais la nouvelle étape s’exécutera selon les capacités du nouveau modèle.
Le modèle souhaité n’apparaît pas dans la liste
Vérifiez l’organisation connectée, puis demandez si son administrateur a connecté le service correspondant. Les modèles de la plateforme sont fournis par la version actuelle de TabTin ; les modèles BYOK dépendent de l’organisation. Vous ne pouvez pas ajouter personnellement à la liste un modèle dont le service n’est pas connecté.
Comment choisir entre 1M, 262K et 200K ?
Estimez la longueur totale des données d’entrée : une question courte ne nécessite pas 1M ; privilégiez 1M pour de longues bases de code, de longs documents ou plusieurs étapes d’analyse. 256K ou 262K suffit généralement aux tâches moyennes. Si le contenu est souvent tronqué, choisissez un contexte supérieur ou découpez la tâche.
Pourquoi la vitesse ou les résultats d’un même modèle varient-ils ?
Les services évoluent et les forfaits de l’organisation peuvent changer les limites de débit, les quotas et la profondeur de raisonnement par défaut. En cas de variation, consultez les capacités actuelles du sélecteur, puis comparez deux modèles avec la même entrée. Ne concluez pas à partir d’une seule réponse.
Vous n’y arrivez toujours pas ?
Envoyez à l’assistance TabTin le nom complet du modèle, son groupe (plateforme ou BYOK de l’organisation), le besoin éventuel d’outils, l’heure du problème et les valeurs de contexte et de raisonnement affichées à droite du sélecteur. Ces informations facilitent la reproduction et le diagnostic. Si le problème persiste, envoyez une capture du message d’erreur à contact@larchiveai.com pour que nous vous aidions. Cette adresse convient aussi aux questions de paiement et de crédits ; si vous êtes dans le groupe de test, contactez directement votre interlocuteur.