モデルとAI · 約8分 · 更新日 2026-09-02
モデルにはどのような違いがあり、それぞれどんなタスクに向いていますか?
コンテキストウィンドウ、推論の深さ、ツール機能でモデルを選びます。複雑な開発、長文書、画像分析、日常の質問には、それぞれ適した選択肢があります。
モデルは大きければよいとは限りません。長いコンテキスト、深い推論、画像理解、ツール呼び出しが必要かを確認してから選びましょう。モデルリストと機能表示はバージョンにより変わります。本記事は現在のクライアントで確認した結果に基づきます。
まず押さえるポイント
- 短い質問や数行の文章の修正:軽量で応答の速いモデルを優先します。
- 長文書の読み取り、複雑な開発、複数段階のタスク:長いコンテキストと深い推論に対応するモデルを優先します。
- 検索、文書を開く操作、表やブラウザーの操作:まずツール呼び出しに対応しているか確認します。
- 「会話のみ」とある場合:会話、要約、書き換えはできますが、現在のクライアントでは検索や表などのツールを呼び出しません。
まずタスクに合わせて選ぶ
| やりたいこと | 最初に試す候補 | 選ぶときの確認点 |
|---|---|---|
| 日常の質問、書き換え、要約 | DeepSeek-V4-flash、Doubao Seed 2.0 Lite | 応答速度、ツールの必要性 |
| 複雑な開発、コード移行、長い作業手順 | GLM-5.2、DeepSeek-V4-pro、Kimi K3 | コンテキストウィンドウ、推論の深さ、ツール呼び出し |
| コーディングタスク | Kimi K2.7 Code、GLM-5.2、DeepSeek-V4-pro、Doubao Seed Evolving | ツールへの対応、コンテキストの長さ |
| 画像やその他のマルチモーダルコンテンツ | Kimi K3、Kimi K2.7 Code、Doubao Seed 2.0 Lite | マルチモーダル機能、ツールの必要性 |
| 会話、要約、書き換えのみ | MiniMax-M3、MiniMax M3 (1M) | 「会話のみ」の表示。ツールは呼び出せません |
| 同時実行が多い場合、予算を重視する場合 | DeepSeek-V4-flash | 軽量モデルの速度とコストの表示。実際の料金はプランまたは接続先サービスに従います |
上の表は現在のクライアントの機能表示を整理した出発点であり、固定の順位ではありません。モデル名、機能、価格は変わる可能性があるため、実際に選ぶ前にモデル選択画面の最新表示を確認してください。
モデルカードの3つの機能を確認する
コンテキストウィンドウ
コンテキストウィンドウは、1回の会話で扱える内容の量を決めます。1Mは長いコードベース、長文書、長い議事録に、262Kや256Kは中程度の長さのタスクに適しています。200Kは通常の質問には十分ですが、実際のタスクの長さも考慮してください。コンテキストが長いほど回答がよいとは限りません。内容が多いほど、明確な依頼が必要になります。
推論の深さ
モデル選択画面には「オフ」「標準」「深い」などの選択肢が表示されます。通常の質問は「オフ」か「標準」から始め、複雑な推論、コード移行、長い作業手順では「深い」に上げます。深い推論は通常、待ち時間が長くなり、接続先の利用枠も多く消費する可能性があります。
ツール呼び出し
検索、文書を開く操作、表の操作、ブラウザーの使用には、ツール呼び出し対応モデルを選ぶ必要があります。「会話のみ」のモデルには明示的な表示があり、選択後も右側にツール機能が表示されません。これは不具合ではなく、そのモデルサービス自体の制限です。
現在のモデルの使い分け
プラットフォームモデル:すぐに使える
プラットフォームモデルはTabTinがサービスを提供するため、APIアドレスやキーを別途入力する必要はありません。現在のクライアントでは、プラットフォーム別に「火山エンジン」と「Moonshot」の2グループに分かれています。
- GLM-5.2:複雑な開発、長いコンテキストの理解、長期にわたるタスクに適しています。モデルカードには1Mコンテキストと、より柔軟な推論強度への対応が表示されています。
- DeepSeek-V4-pro:本番用Agent、複雑なコーディング、長いコンテキストを要するタスクに適しています。モデルカードには総パラメーター1.6T、アクティブパラメーター49B、1Mコンテキストと表示されています。
- DeepSeek-V4-flash:同時実行が多く、コストを重視する日常タスクに適しています。モデルカードでは軽量版とされ、1Mコンテキストに対応しています。
- Doubao Seed Evolving:Coding、Agent、生産性向上の用途に適しています。共通のモデルIDを使用し、機能は継続的に進化します。
- Doubao Seed 2.0 Lite:日常の質問、軽い分析、画像やツールが必要な中程度のタスクに適しています。モデルカードには256Kコンテキスト、マルチモーダル、ツール機能が表示されています。
- Kimi K3:長文書、複雑な推論、マルチモーダルタスクに適しています。モデルカードには1Mコンテキスト、常時推論と表示され、推論の深さを調整できます。
- Kimi K2.7 Code:コーディングタスクに適しています。モデルカードには262Kコンテキスト、マルチモーダル、ツール、推論機能が表示されています。
- Kimi K2.6 / K2.5:中長程度のコンテキストを使う一般的な質問、分析、コーディングに適しています。モデルカードには262Kコンテキスト、マルチモーダル、ツール、推論機能が表示されています。
組織BYOK:組織が接続したモデルサービスを使う
「組織BYOK」と表示される場合は、組織管理者が接続したモデルサービスです。現在のクライアントの例では、MiniMaxモデルに「会話のみ」の表示があります。
- MiniMax-M3:コンテキストウィンドウは200Kで、会話、要約、書き換えなど、ツールを必要としないタスクに適しています。
- MiniMax M3 (1M):名前に1Mとありますが、現在のクライアントでは「会話のみ」と表示されます。実際のコンテキストウィンドウは選択後の右側の表示を確認してください。検索、表、ブラウザーのツールが使えるという意味ではありません。
BYOKで利用可能なモデル、コンテキスト、課金は、組織の設定と接続先サービスによって決まります。モデルが見つからない場合は、まず組織管理者にサービスの接続状況と利用枠の残量を確認してください。
タスク内でモデルを確認・切り替える
1. モデル選択画面を開く
新しいタスクを作成し、入力欄の下の現在のモデル名をクリックします。モデルはプラットフォームと組織BYOKでグループ分けされています。モデルを選ぶと、右側に機能情報が表示されます。
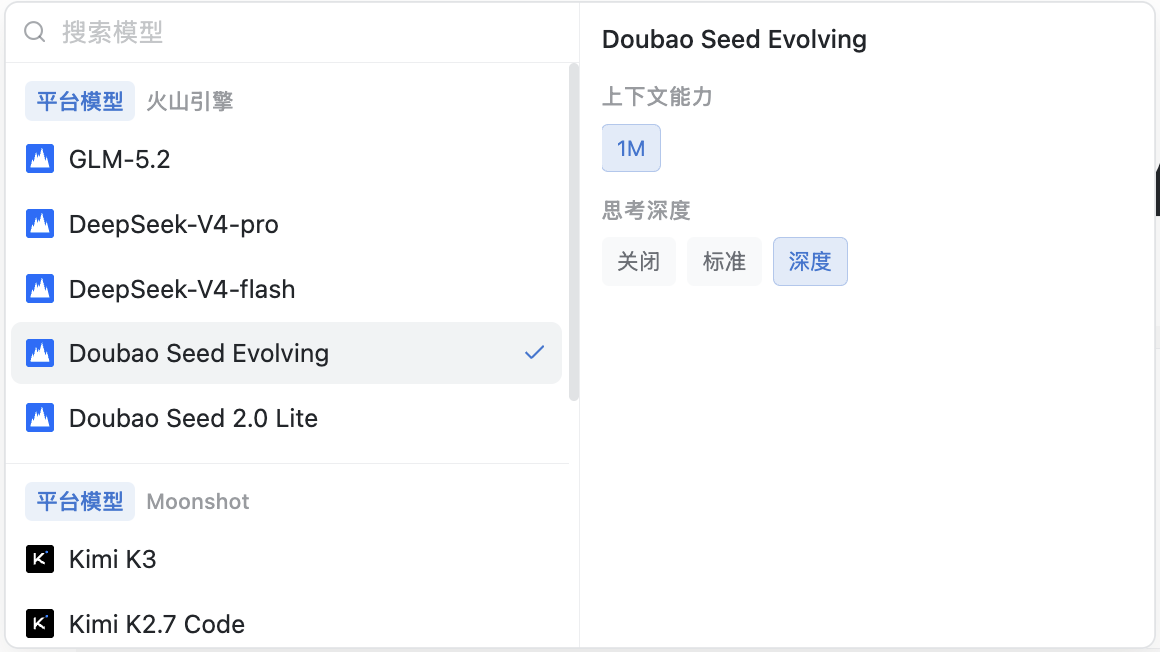
図1・モデル選択画面にプラットフォームのグループ、組織BYOK、「コンテキストウィンドウ」「推論の深さ」が表示されています。
2. 長いコンテキストと推論の深さを確認する
リストからKimi K3、GLM-5.2などを選び、右側の「コンテキスト機能」と「推論の深さ」を確認します。長い資料を処理する場合はコンテキストウィンドウを優先し、複雑な推論が必要なら推論強度を上げます。
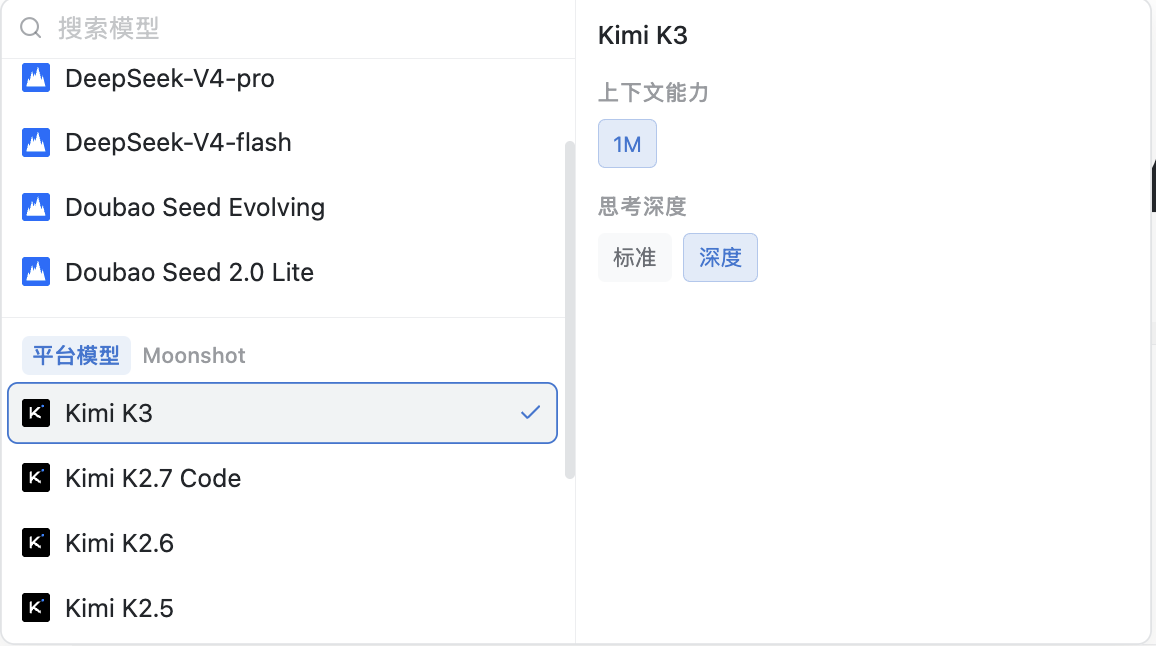
図2・Kimi K3は現在1Mコンテキストと表示され、推論の深さは「標準」「深い」の2段階から選べます。
3. 会話のみのモデルを見分ける
組織BYOKモデルには「会話のみ」と表示される場合があります。現在のクライアントのMiniMax-M3とMiniMax M3 (1M)はどちらもこの種類です。テキストのタスクに適していますが、検索、表、ブラウザーが必要なタスクには適していません。
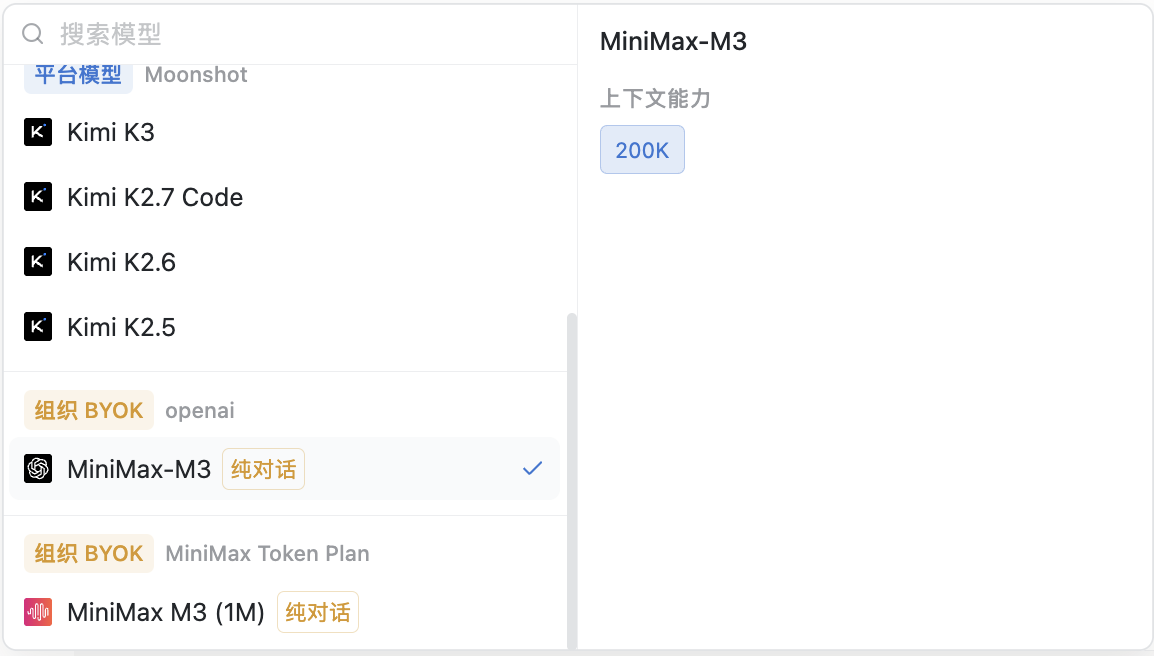
図3・MiniMaxモデルには「会話のみ」の表示があり、右側にはコンテキストウィンドウも表示されます。
よくあるトラブルの確認
会話はできるが、検索や表の操作ができない
モデル名の横に「会話のみ」の表示がないか確認し、ツール呼び出しに対応するプラットフォームモデルに切り替えてください。切り替えても送信済みメッセージは失われませんが、次のやり取りから新しいモデルの機能で実行されます。
使いたいモデルがリストにない
正しい組織にログインしているか確認し、組織管理者が該当サービスを接続しているかを確認してください。プラットフォームモデルは現在のTabTinのバージョンが提供し、組織BYOKモデルは組織が設定します。未接続のモデルを個人がリストに追加することはできません。
1M、262K、200Kはどう選ぶべきですか?
入力資料の総量を目安にしてください。短い質問に1Mは必須ではありません。長いコードベース、長文書、複数回にわたる資料分析では1Mを優先し、中程度のタスクなら256Kや262Kで通常は十分です。頻繁に内容が切り捨てられる場合は、より大きなコンテキストに変えるか、タスクを分割してください。
同じモデルでも速度や結果が変わるのはなぜですか?
モデルサービスは更新され、組織のプランでもレート制限、利用枠、推論の深さの初期設定が変わる場合があります。ばらつきがあるときは、まずモデル選択画面の現在の機能表示を確認し、同じ入力で2つのモデルを比較してください。1回の回答だけで判断しないようにしましょう。
解決しない場合
TabTinサポートには、モデルの正式名称、所属グループ(プラットフォームモデルまたは組織BYOK)、ツールが必要なタスクか、問題の発生時刻、選択画面の右側に表示されるコンテキストと推論の深さを伝えてください。再現と原因特定がしやすくなります。それでも解決しない場合は、エラーのスクリーンショットをこちらに送ってください。 contact@larchiveai.com。こちらで確認します。支払いやクレジットの問題もこのメールアドレスに送れます。ベータテストグループに参加している場合は、担当者へ直接連絡することもできます。